数据集成 数字化转型的核心引擎与数据处理存储支持服务
在数字化转型的浪潮中,数据已成为企业的核心资产。孤岛式的系统、异构的数据源以及实时性的业务需求,使得数据集成的重要性愈发凸显。2人赞同了该文章,或许正是因为这一共识:没有高效的数据集成,数字化转型便如同无源之水。
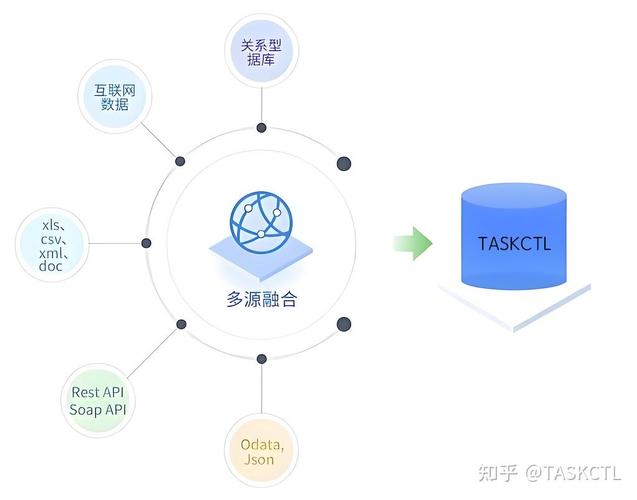
数据集成并非简单的数据搬运,而是将来自不同来源、不同格式、不同系统的数据,在逻辑上或物理上有机地汇聚在一起,为用户提供统一的访问接口。它是打破数据孤岛、实现数据价值最大化的关键一步。从ERP、CRM到IoT传感器、社交媒体,企业每天产生的数据量呈指数级增长,若无法整合,这些数据只会成为负担而非资产。
集成只是起点,真正的挑战在于后续的数据处理与存储支持服务。数据处理涵盖了清洗、转换、聚合、分析等一系列操作,确保数据的准确性、一致性和可用性。例如,在实时风控场景中,数据集成需毫秒级完成,再经由流处理引擎进行复杂的事件关联,最终将结果存储到高性能数据库中,供决策使用。
存储支持服务则是数据集成与处理的基石。随着数据类型从结构化向半结构化、非结构化扩展,存储方案也必须多样化:关系型数据库适合事务性数据,NoSQL应对海量异构数据,数据湖则能容纳原始格式的数据,供后续按需分析。存储的扩展性、可靠性和成本效益直接决定了数据集成架构的可持续性。
在数字化转型的实践中,一个典型的数据集成平台往往包含以下组件:连接器层负责从源系统抽取数据;转换层执行清洗与标准化;路由层决定数据流向;而存储层则提供持久化与查询能力。这些组件需要协同工作,并支持批处理与流处理的统一。例如,Apache NiFi、Apache Kafka、Apache Flink等开源工具,以及云原生的数据集成服务(如AWS Glue、Azure Data Factory),正在成为企业构建数据管道的标配。
值得注意的是,数据集成并非一劳永逸。随着业务变化、新系统上线、合规要求更新,集成流程需要持续监控与优化。数据质量、元数据管理、血缘追踪等能力,同样是数据处理与存储支持服务中不可或缺的部分。只有将集成、处理、存储视为一个整体,才能构建出灵活、可扩展、可信赖的数据架构。
在数字化转型的今天,数据集成的重要性不言而喻。它不仅是技术层面的连接,更是业务层面的赋能。而强大的数据处理与存储支持服务,则为这一过程提供了坚实的底座。企业唯有在这三者的协同上下功夫,才能真正释放数据的潜能,驱动智能决策与创新增长。
如若转载,请注明出处:http://www.hlkaldksa.com/product/51.html
更新时间:2026-10-15 12:17:18